
評測 Agent 的核心任務非常單純:讀題目的測試用例與學生的程式碼,推測哪幾段會過,並將結果分別餵給 UI 與導師 Agent。
這看似只是一次普通的 LLM 呼叫,但為了確保系統的穩定度與引導邏輯不被破壞,程式碼裡設計了嚴密的 5 步驟處理流程與「雙出口防漏」機制。
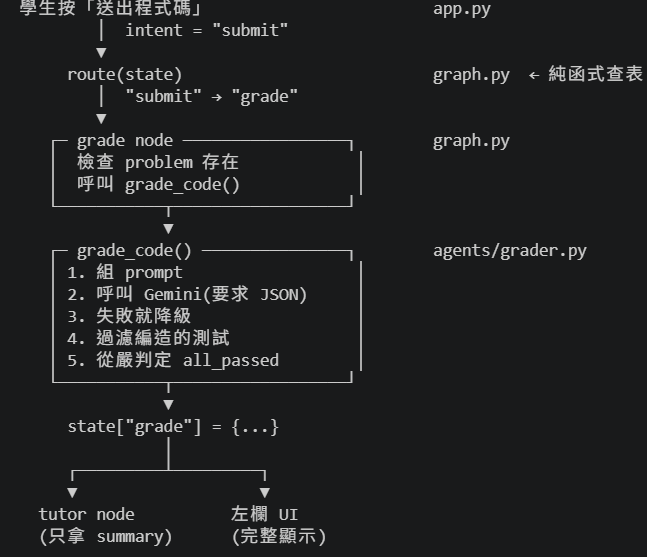
在 agents/grader.py 裡,評測邏輯被拆成五個嚴謹的處理步驟:
將題目說明、entry_point、測試原文與學生的程式碼打包交給 Gemini。在 system_instruction 中直接下達硬約束:「你不會執行這些程式碼」、「不確定就當成不通過」,從源頭控制模型的推測邊界。
利用 response_schema 強制要求模型輸出固定的 JSON 結構:
JSON
{
  "all_passed": true,
  "failed": ["assert find_value({}, 'x') == 'Not Found'"],
  "summary": "當字典為空時,未正確處理 KeyError。"
}
網路錯誤、API 回傳空白或不是合法 JSON 時,絕不拋出例外讓系統崩潰,而是回傳 parsed_ok = False 且 all_passed = None。
這裡的靈魂在於 None 的三態設計:
解析失敗時完全無法得知真實狀況,直接斷言成 False 也是一種虛假的宣稱。明確標示 None 能讓 UI 誠實顯示「這次沒有結果」,而不是給學生劃一個紅叉。
LLM 偶爾會產生幻覺,甚至在回答裡「憑空捏造」題目原本根本沒有寫的測試用例。程式在拿回結果後,會嚴格比對 problem["tests"] 的原文,只要對不上的字串一律丟棄,避免 UI 畫面上印出一段莫名其妙不存在的測試。
判定標準為:all_passed = (旗標為真) and (len(failed) == 0)。
當模型自相矛盾時(例如回答了「全過」,清單裡卻列了失敗項),一律視為「沒過」。高報通過是最昂貴的錯誤——因為在第 3 期,一旦被判定為「全部通過」,系統會直接跳過導師 Agent、自動幫學生切換到下一題。
評測算完之後會寫入 state["grade"],但這份資料送往兩個出口時,內容是有遮蔽的:
| 去處 | 拿到什麼 | 設計原理 |
|---|---|---|
| 左欄 UI | 完整資料(含失敗的測試原文 assert ...) | 學生需要清楚看到自己哪一行測試沒通過,方便改 code。 |
| 導師 Agent | 只有 summary + 失敗數量 | failed 裡面裝的是測試原文(例如 assert add(2, 3) == 5),裡面帶有預期輸出與解答細節。如果給導師看,導師極容易開後門把答案講出來。 |
這樣就可以避免導師直接拿到程式碼,並以程式碼去給予答案了


 iThome鐵人賽
 看影片追技術